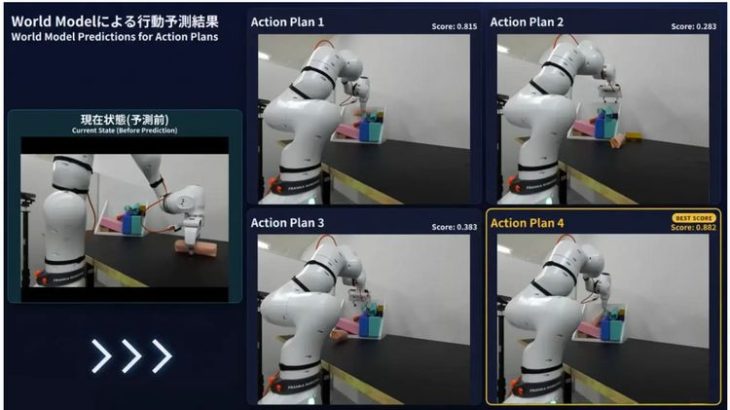
物理法則に基づき荷崩れや落下を予測、空港手荷物など多様な物品の積み込み・積降ろし自動化へ
NTTは11月11日、ロボットが動く前に、複数の行動候補について荷崩れや落下の可能性を予測・評価し、成功につながる行動を選択可能にする技術を開発したと発表した。
具体的には、AIがセンサーなどで集めた情報を基にロボットなどを自律的に制御する技術「フィジカルAI」の基盤として、物体の重さや向き、動く速さなどの情報(物理量)を明示的に扱い、運動方程式に基づいて状態変化を予測するワールドモデルを生み出した。
独自開発した「物理制御アダプタ」を映像生成モデルに統合することで、荷崩れや落下など、物体の相互作用を高精度に予測できるという。公開ベンチマークで従来手法を上回る精度を確認するとともに、荷物の積み付け作業を模擬した小型ロボットによる棚積みタスクでは、成功率が73.1%から92.3%に向上した。
NTTは新技術の最初の適用領域として、形状や重量の異なる多様な空港手荷物の積み込み・積降ろしを想定している。今後はMujinと連携をしながら社会実証を進め、将来は物流・倉庫、製造、建設、小売など、幅広い分野のフィジカルAIへ展開することを目指す。
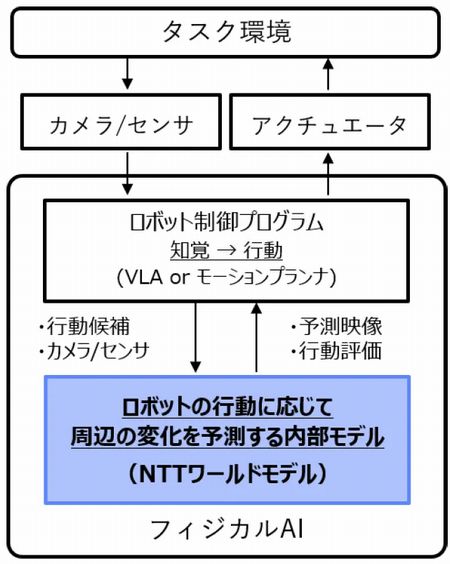
フィジカルAIにおける本技術の位置付け。既存のロボット制御プログラムと連携し、行動前に周辺環境の変化を予測・評価する
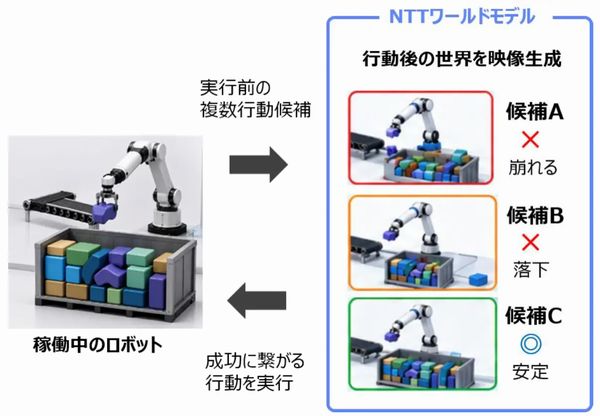
新技術による行動選択の概要。複数の行動候補について行動後の結果を予測・評価し、成功につながる行動を選択する
新技術は既存のロボット制御ソフトウェアと連携し、その判断を補強する形で適用することが可能という。ロボット制御フローに直接組み込めるよう、精度を維持しつつ高速に動作する構成にしている。
具体的には、VLA(視覚・言語・動作)モデルやモーションプランナー(ロボットの目標と周辺環境の情報から、タスク目標に到達するためのロボット制御を計算するプログラム)などが生成する行動候補について、それぞれを実行した場合の未来を予測し、荷崩れや落下などの結果を行動計画の評価として出力する。
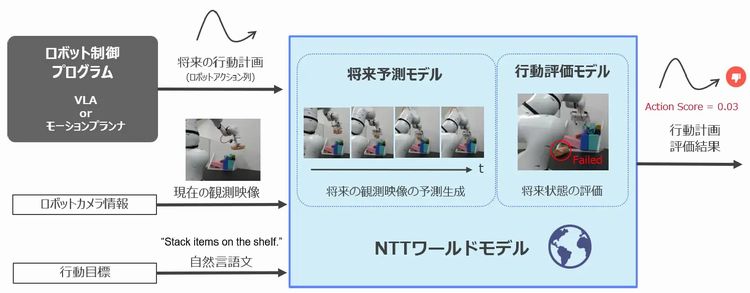
NTTワールドモデルの概要。ロボットの行動計画ごとに将来を予測し、実行前に成否を評価する
ロボット制御プログラムが生成した複数の行動候補について、それぞれを実行した場合の未来を映像として生成する。その映像から、物体の落下や衝突の有無などの結果を予測・評価することで、成功につながる行動を選択可能にし、ロボットの行動失敗率を低減できるとみている。
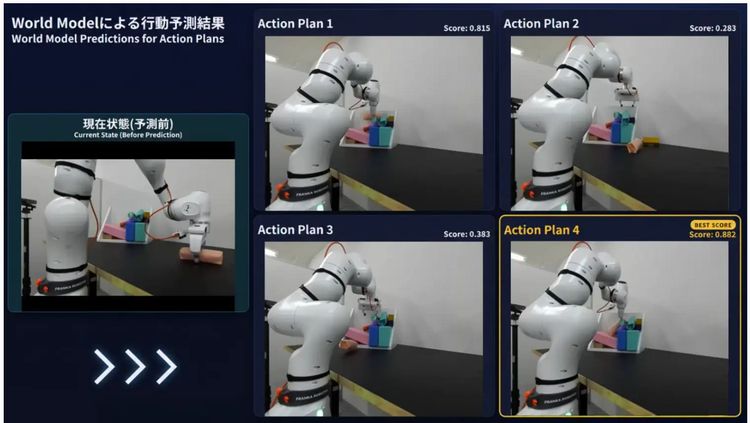
NTTワールドモデルによる複数の行動候補の予測・評価。各候補を実行した場合の将来映像を生成し、成功への繋がりやすさをスコアとして評価する
物体ごとの位置・姿勢・速度・質量などの物理量を明示的に扱い、運動方程式に従う動きとして未来を予測することで、物体の消失や変形を抑え、衝突や崩落などの物体どうしの相互作用をより正確に予測できるようになる。
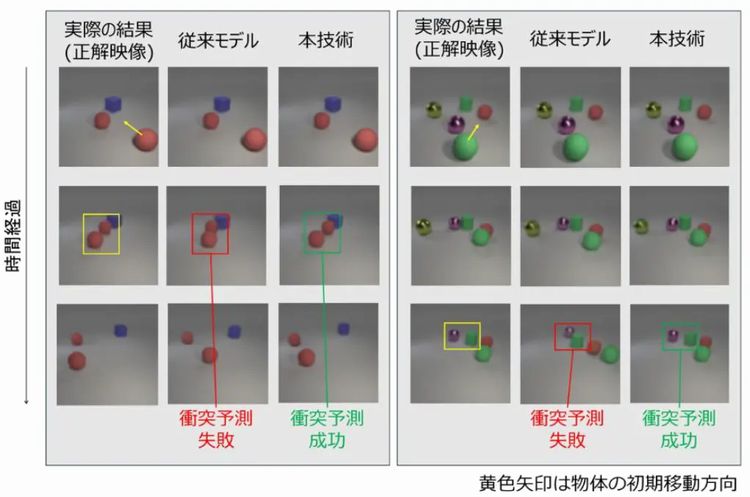
公開ベンチマーク(OBJ3D)における、将来予測結果の比較。物体の衝突を含む場面で、従来モデルは衝突の予測に失敗し(赤枠)、本技術は成功した(緑枠)
物体の物理量を明示的に扱い、物理法則に基づいて状態変化を予測することで、学習データに含まれない場面や動きにも対応が可能。空港手荷物や宅配便の小口荷物など、形状・重量・配置が多様な物品を扱い、学習データの網羅が難しい現場に適しているとみている。
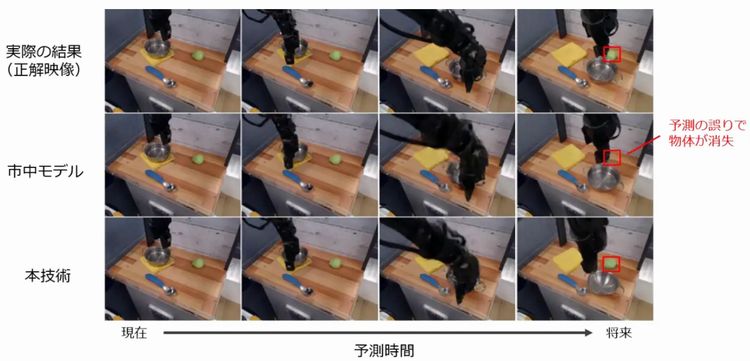
ロボットアームで物体が隠れる、学習データに含まれない場面での予測結果
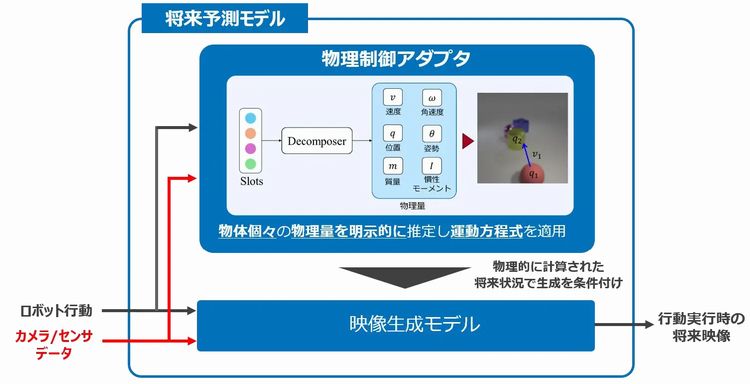
本技術の中核となる将来予測モデルの構成。映像生成モデルに物理制御アダプタを統合し、アダプタで推定した結果を映像生成へ反映することで、高精度な将来映像の生成を実現する
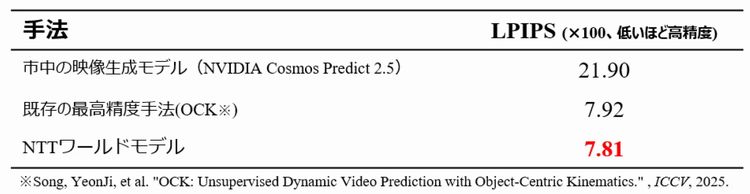
公開ベンチマーク(OBJ3D)における予測映像の精度評価結果
(藤原秀行)※いずれもNTT提供